深度学习基础课:用全连接层识别手写数字(下) | 杨元超的世界
大家好~我开设了“深度学习基础班”的线上课程,带领同学从0开始学习全连接和卷积神经网络,进行数学推导,并且实现可以运行的Demo程序
线上课程资料:
加QQ群,获得ppt等资料,与群主交流讨论:106047770
本系列文章为线上课程的复盘,每上完一节课就会同步发布对应的文章
本课程系列文章可进入索引查看:
目录
任务:恢复梯度检查
- 恢复梯度检查后的代码是什么?
答:恢复后的代码为:ImplementTrain_restore_gradient_check
- 请每个同学都运行代码,看下是否通过了梯度检查?
答:通过了梯度检查
任务:实现推理
- 请实现“使用mnist的测试集推理一个样本”的代码
答:实现后的相关代码为:
let inference = (state: state, feature: feature) => {
 let inputVector = _createInputVector(feature)

 let (_, (_, layer3OutputVector)) = forward(
 (
 _activate_sigmoid(
 _handleInputValueToAvoidTooLargeForSigmoid(
 Matrix.getColCount(state.wMatrixBetweenLayer1Layer2),
 ),
 ),
 _activate_sigmoid(
 _handleInputValueToAvoidTooLargeForSigmoid(
 Matrix.getColCount(state.wMatrixBetweenLayer2Layer3),
 ),
 ),
 ),
 inputVector,
 state,
 )

 layer3OutputVector -> _getOutputNumber
}

...

let mnistData = Mnist.set(1, 1)

let features = mnistData.training->Mnist.getMnistData
let labels = mnistData.training->Mnist.getMnistLabels

inference(state, features[0])->Js.log
- 请实现“使用mnist的测试集推理多个样本,并给出正确率”的代码
答:待实现的代码为:ImplementTrain_inference_many,实现后的代码为:ImplementTrain_inference_many_answer
- 请每个同学都运行代码,查看推理正确率是否接近100%?
答:正确率只有不到40%左右
主问题:如何解决过拟合?
- 现在在训练和推理时,正确率分别是什么情况?
答:推理正确率小于训练正确率
- 这被称为过拟合
- 请根据该图,说下三种拟合情况?
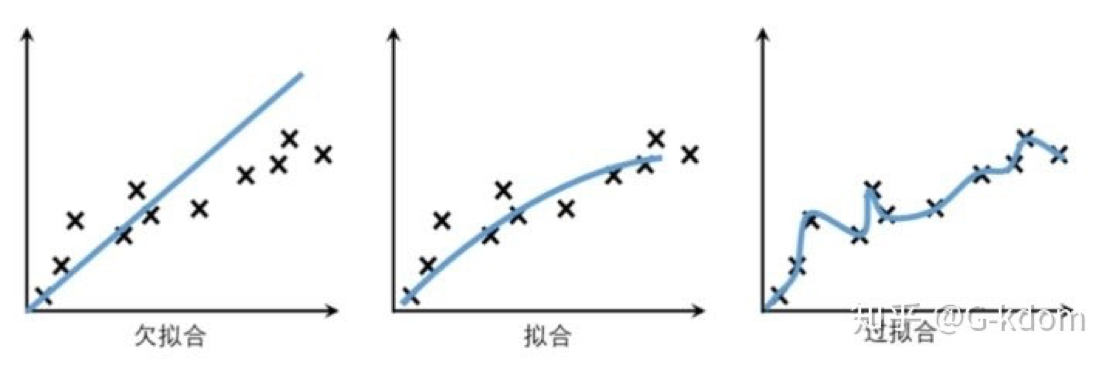
- 为什么会出现过拟合?
答:因为训练集样本太少
- 如何解决现在遇到的过拟合的问题?
答:增加训练样本个数
- 如果想要使每次训练的样本个数较小(从而训练时间更快),但又能达到更大训练样本个数的效果,该如何做?
答:训练数据集shuffle
- Shuffle是什么?
答:随机从较大的数据集中选择较小的数据集
- 为什么Shuffle能避免过拟合?
答:如下图所示,固定的数据集顺序意味着固定的训练样本,也就意味着权值更新的方向是固定的,而无顺序的数据集,意味着更新方向是随机的,更容易到最优点
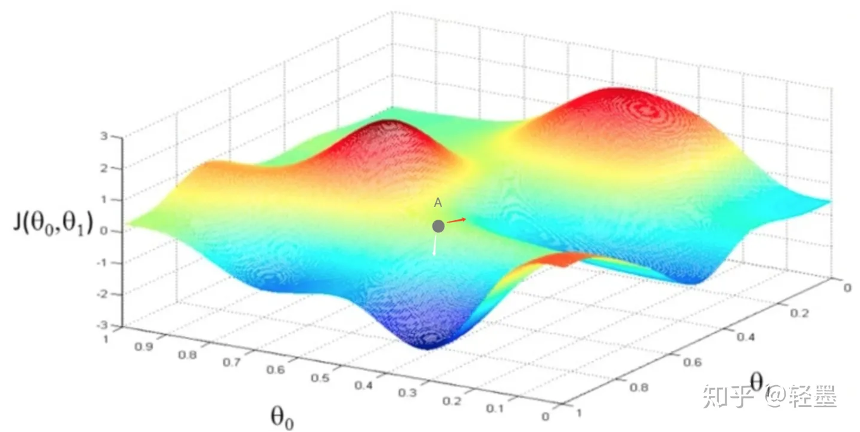
任务:解决过拟合
- 请实现所有解决方案的代码
答:实现后的代码为:ImplementTrain_solve
- 请每个同学分别运行每个解决方案的代码,看下是否都提高了推理正确率?
答:是的
- 请每个同学观察实现第二个接近方案(shuffle)前和实现后的正确率的变化趋势,说明为什么这样变化?
答:实现“shuffle”后,训练正确率会有起伏,这是因为权重更新方向是随机的;并且推理正确率高于训练正确率,这是因为shuffle提高了神经网络的泛化能力
- 请每个同学运行包含两个解决方案的代码,看下是否提高了推理正确率?
答:是的
结学
什么现象属于过拟合?
如何解决过拟合?
总结
请总结本节课的内容?
请回答所有主问题?