深度学习基础课:使用小批量随机梯度下降 | 杨元超的世界
大家好~本课程为“深度学习基础班”的线上课程,带领同学从0开始学习全连接和卷积神经网络,进行数学推导,并且实现可以运行的Demo程序
线上课程资料:
加QQ群,获得ppt等资料,与群主交流讨论:106047770
本系列文章为线上课程的复盘,每上完一节课就会同步发布对应的文章
本课程系列文章可进入索引查看:
目录
回顾相关课程内容
- 对于随机梯度下降,多少个样本更新一次权重?
为什么要学习本课
- 如何改进随机梯度下降算法?
如何充分利用CPU缓存?
- 如何更接近损失函数的极小值?
主问题:如何充分利用CPU缓存?
- 我们现在使用什么方法更新权重?
答:随机梯度下降
- 除此之外还有什么方法吗?
答:梯度下降
- 它们分别是多少个样本更新一次权重?
答:随机梯度下降使用一个样本更新一次权重;梯度下降使用所有的样本,求梯度的平均后更新一次权重
- 哪种方法更能利用CPU缓存?为什么?
答:梯度下降,因为它一次性输入所有的样本,能更好地利用缓存
- 但是该方法有什么问题?
答:如果样本数量太多,可能超出缓存大小,影响性能;计算所有样本的梯度平均后才更新一次权重,花费的时间太多,相应太慢
- 能否提出一个折中的方法?
答:小批量随机梯度下降。该方法使用一个批量的样本,求梯度平均后更新一次权重。有多少批量,就更新多少次权重
- 该方法有什么优势?
答:批量的样本数量可以任意设置,使其不超出缓存大小,又能占满缓存空间,充分利用缓存;相对于梯度下降,更新权重的次数变多,从而每次更新的时间变少,加快相应速度
主问题:如何更接近损失函数的极小值?
- 如图所示是梯度下降算法的几何意义
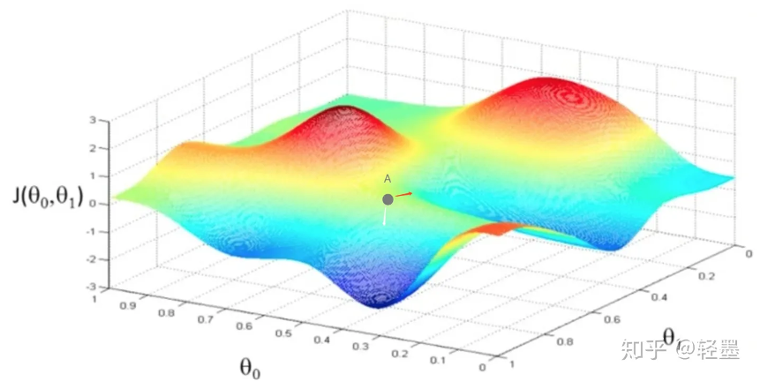
- 随机梯度下降算法是否总能达到极小值处?
答:否
- 可能会出现什么情况?
答:在极小值处震荡
- 小批量随机梯度下降是如何改进的?
答:相比随机梯度下降,会更直接地达到极小值处,减少震荡和绕弯路。
我们再从代数上来理解
对于随机梯度下降,梯度等于什么?
答:(g = \frac{dE}{dw})
- 对于小批量随机梯度下降,梯度等于什么?
答:(g = \frac{1}{\beta} \sum_{i \in \beta} \frac{dE}{dw})
- 相比随机梯度下降,期望是否一样?
答:一样。
因为期望约等于平均值,而小批量随机梯度下降的梯度是在计算平均值,平均值的期望约等于原值的期望,所以期望不变
- 相比随机梯度下降,标准差是否下降了?
答:(下降了,标准差为原来的 \frac{1}{\sqrt{\beta}})
结学
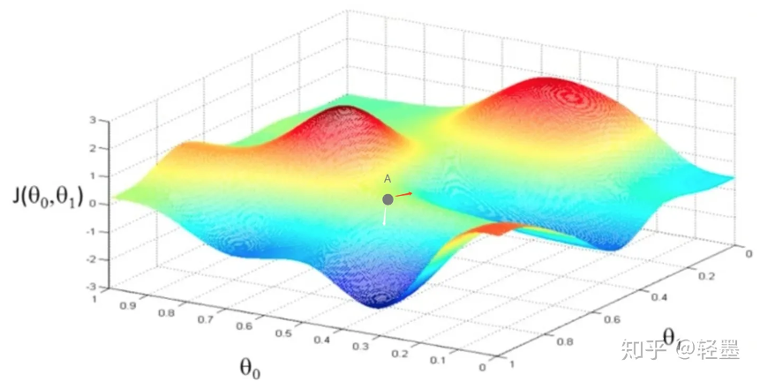
- 从几何上来看
三种更新权重方法分别会如何接近损失函数的极小值?
- 从代数上来看
小批量随机梯度下降相比随机梯度下降,期望和标准差有什么变化?
任务:实现小批量随机梯度下降
- 请在“识别手写数字”Demo中实现小批量随机梯度下降
答:待实现的代码:Minibatch,实现后的代码:Minibatch_answer
- 请每个同学都运行代码,分别与梯度下降、随机梯度下降比较每轮的时间、收敛速度
答:
运行Minibatch_answer代码,调整train的参数
测试梯度下降:训练样本数取100,miniBatchSize取100
前4轮的收敛情况为:
[ 'loss:', 2.7084382520998895 ]
[ 'getCorrectRate:', '10%' ]
[ 'loss:', 2.553819845325052 ]
[ 'getCorrectRate:', '15%' ]
[ 'loss:', 2.443912505188381 ]
[ 'getCorrectRate:', '17%' ]
[ 'loss:', 2.3617236859557043 ]
[ 'getCorrectRate:', '21%' ]
测试随机梯度下降:训练样本数取100,miniBatchSize取1
前4轮的收敛情况为:
[ 'loss:', 2.0895738788666964 ]
[ 'getCorrectRate:', '26%' ]
[ 'loss:', 1.067310882730676 ]
[ 'getCorrectRate:', '71%' ]
[ 'loss:', 0.5722998319431286 ]
[ 'getCorrectRate:', '85%' ]
[ 'loss:', 0.3622678286495109 ]
[ 'getCorrectRate:', '94%' ]
测试小批量随机梯度下降:训练样本数取200,miniBatchSize取2,使更新权重的次数与随机梯度的更新次数一样,都为100
前4轮的收敛情况为:
[ 'loss:', 1.86769048890096 ]
[ 'getCorrectRate:', '42.5%' ]
[ 'loss:', 0.9562183977660103 ]
[ 'getCorrectRate:', '81%' ]
[ 'loss:', 0.6213491872632919 ]
[ 'getCorrectRate:', '88%' ]
[ 'loss:', 0.4314509748028065 ]
[ 'getCorrectRate:', '94%' ]
通过对比可知,每轮的时间从小到大依次为:梯度下降、小批量随机梯度下降、随机梯度下降
收敛速度从小到大依次为:梯度下降、随机梯度下降、小批量随机梯度下降